Компания NVIDIA заявила, что рост сложности ИИ-моделей и увеличение контекстных окон создают критическую нагрузку на память GPU. Вместо простого наращивания объема HBM-памяти, компания делает ставку на подход full-stack codesign — совместное проектирование GPU, CPU, сетевых компонентов и ПО. Это позволяет эффективнее распределять данные между уровнями иерархии памяти: от быстрой HBM до более медленных SSD и общих хранилищ. Согласно данным компании, использование этого подхода позволило повысить пропускную способность на доллар в задачах с агентными моделями до 30 раз при переходе к платформе Vera Rubin. Технологии оптимизации включают сжатие весов моделей, выгрузку неактивного контекста KV-кэша на более дешевые уровни хранения и компактное размещение индексов RAG вне HBM. По утверждению NVIDIA, такой метод позволяет увеличить количество полезных токенов на ватт и снизить общие затраты на инференс.
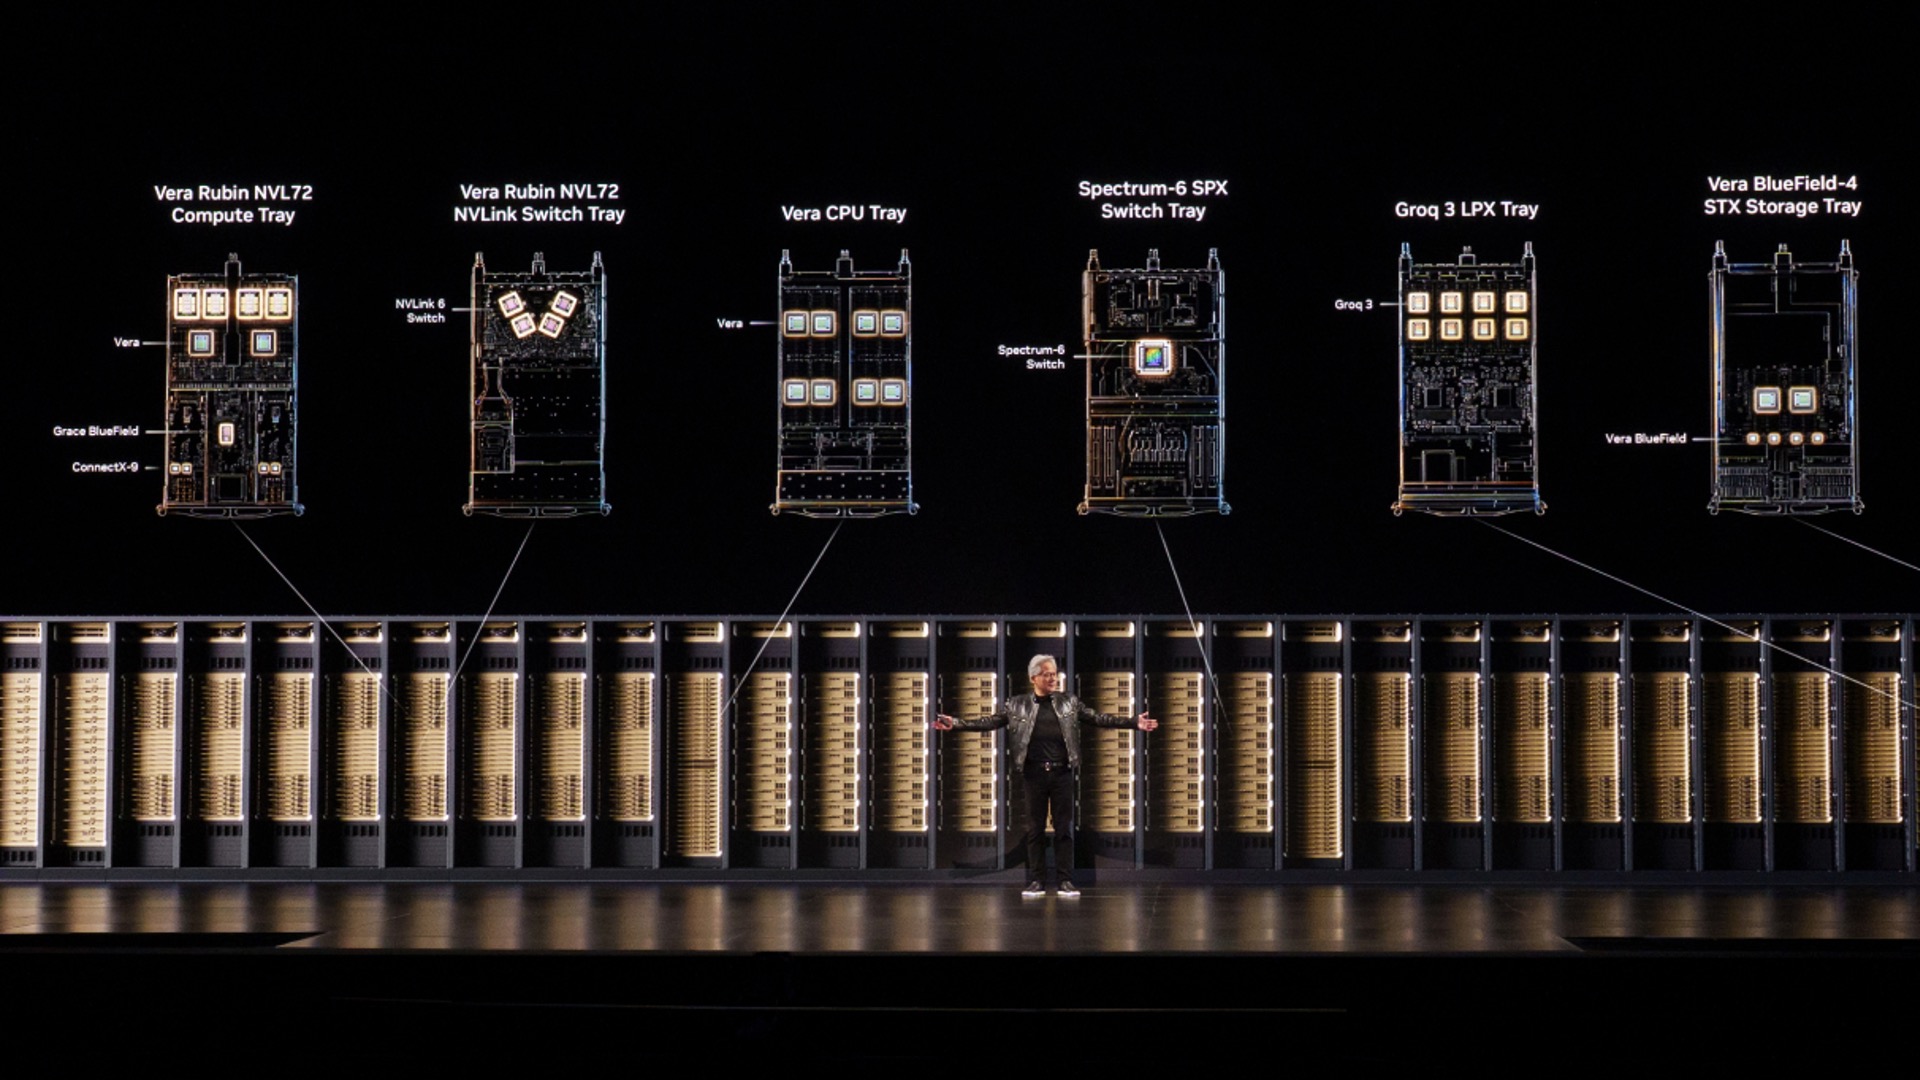
NVIDIA представила подход full-stack codesign для оптимизации памяти в ИИ-системах
NVIDIA внедряет комплексное проектирование аппаратного и программного обеспечения для борьбы с нехваткой памяти GPU при работе с крупными ИИ-моделями.